pomoc za ucenje pythona
Zaključano
Zakačeno
Sa mojim skoro nepostojećim znanjem pythona i uz googlanje, došao sam do nekog koda
E sad je problem što ovo upisivanje u fajl na kraju ne radi. Napravi fajl novi.txt, ali je prazan. Ne upiše to što izlistava na ekranu.
Gde gešim?
Code:
import re
# Otvori fajl
with open("original.txt", encoding='utf-8') as of:
for line in of:
# Podeli tekst kad naiđeš na '.' or ? or !.
for l in re.split(r"\.|\?|\!",line):
# Izlistaj na ekranu
print(l)
# Upiši rezultat u novi.txt
with open('novi.txt', 'w') as nf:
print(l, file=nf)
import re
# Otvori fajl
with open("original.txt", encoding='utf-8') as of:
for line in of:
# Podeli tekst kad naiđeš na '.' or ? or !.
for l in re.split(r"\.|\?|\!",line):
# Izlistaj na ekranu
print(l)
# Upiši rezultat u novi.txt
with open('novi.txt', 'w') as nf:
print(l, file=nf)
E sad je problem što ovo upisivanje u fajl na kraju ne radi. Napravi fajl novi.txt, ali je prazan. Ne upiše to što izlistava na ekranu.
Gde gešim?
Citat:
Please use the NLTK Downloader to obtain the resource:
>>> import nltk
>>> nltk.download('punkt')
>>> import nltk
>>> nltk.download('punkt')
Lepo ti kaže, prvo nltk.download('punkt'), pa onda pokreni kod.
Code (python):
import csv
import nltk
nltk.download('punkt')
with open('/putanja/do/tvoj_fajl.csv', 'w', newline='') as csv_file:
writer = csv.writer(csv_file)
try:
fh = open('/putanja/do/tvoj_fajl.txt')
lines = fh.read().replace('\n', '')
lines = nltk.sent_tokenize(lines)
for line in lines:
writer.writerow([line])
except IOError as e:
print(f'OS error: {e}')
finally:
fh.close()
Citat:
E sad je problem što ovo upisivanje u fajl na kraju ne radi. Napravi fajl novi.txt, ali je prazan. Ne upiše to što izlistava na ekranu.
Gde gešim?
Gde gešim?
Umesto w (write) stavi a (append): with open('novi.txt', 'a') as nf
Mislim da si odabrao pogrešan problem za učenje Pythona.
NLP je ozbiljan problem, a nltk komplikovan paket. Procesiranje prirodnih jezika je težak problem za veštačku inteligenciju.
Kažeš, želiš da ispišeš svaku rečenicu iz teksta u novom redu.
E, sada dolazi kvaka 22: definiši šta je to rečenica u tekstu pisanom u nekom prirodnom jeziku. Daj mi bilo koju definiciju, a ja ću ti dati 10 primera koji će da pokažu da postoje rečenice koje se ne uklapaju u tvoju definiciju.
Nećeš daleko da stigneš, a Python će ti biti najmanji problem...
@a1234567
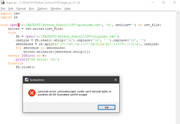
Sto se tice greske sa poslednjeg screenshota, ne mozes da koristis backslash (\) karakter unutar stringa, jer on ima specijalno znacenje i sluzi za definisanje escape sequenci. Da bi ubacio taj karakter u string, moras i njega da "ekskejpujes" (jbg, ne znam nas termin), tako sto koristis dupli backslash "\\".
dakle, umjesto ovog:
stavi ovo:
Sto se tice greske sa poslednjeg screenshota, ne mozes da koristis backslash (\) karakter unutar stringa, jer on ima specijalno znacenje i sluzi za definisanje escape sequenci. Da bi ubacio taj karakter u string, moras i njega da "ekskejpujes" (jbg, ne znam nas termin), tako sto koristis dupli backslash "\\".
dakle, umjesto ovog:
Code:
a = 'c:\neka\putanja.txt'
stavi ovo:
Code:
a = 'c:\\neka\\putanja.txt'
Citat:
Panta_:
Lepo ti kaže, prvo nltk.download('punkt'), pa onda pokreni kod.
Citat:
Please use the NLTK Downloader to obtain the resource:
>>> import nltk
>>> nltk.download('punkt')
>>> import nltk
>>> nltk.download('punkt')
Lepo ti kaže, prvo nltk.download('punkt'), pa onda pokreni kod.
Code (python):
import csv
import nltk
nltk.download('punkt')
with open('/putanja/do/tvoj_fajl.csv', 'w', newline='') as csv_file:
writer = csv.writer(csv_file)
try:
fh = open('/putanja/do/tvoj_fajl.txt')
lines = fh.read().replace('\n', '')
lines = nltk.sent_tokenize(lines)
for line in lines:
writer.writerow([line])
except IOError as e:
print(f'OS error: {e}')
finally:
fh.close()
import nltk
nltk.download('punkt')
with open('/putanja/do/tvoj_fajl.csv', 'w', newline='') as csv_file:
writer = csv.writer(csv_file)
try:
fh = open('/putanja/do/tvoj_fajl.txt')
lines = fh.read().replace('\n', '')
lines = nltk.sent_tokenize(lines)
for line in lines:
writer.writerow([line])
except IOError as e:
print(f'OS error: {e}')
finally:
fh.close()
Panto, genije si. Punkt punktiran, da ne kažem daunlodovan. I sada tvoj kod radi kao sat.
Evo i dokaz

E a sad dolazi faza 2. Ovo je ubačen originalni tekst. Sad da iseckam prevod tog teksta, to znam kako ću. Ali kako da ga ubacim u istu ovu tabelu, ali da ga stavi u drugu kolonu, tako da se upari sa prvom?
Citat:
djoka_l:
Mislim da si odabrao pogrešan problem za učenje Pythona.
NLP je ozbiljan problem, a nltk komplikovan paket. Procesiranje prirodnih jezika je težak problem za veštačku inteligenciju.
Kažeš, želiš da ispišeš svaku rečenicu iz teksta u novom redu.
E, sada dolazi kvaka 22: definiši šta je to rečenica u tekstu pisanom u nekom prirodnom jeziku. Daj mi bilo koju definiciju, a ja ću ti dati 10 primera koji će da pokažu da postoje rečenice koje se ne uklapaju u tvoju definiciju.
Nećeš daleko da stigneš, a Python će ti biti najmanji problem...
E baš si me ohrabrio. :)))
Pa još da definišem rečenicu. Pa nisam ja veštačka inteligencija :))
Sve je pod kontrolom. Ja i ne nameravam daleko da stignem, već da nešto naučim. Koliko, videćemo. Nisam u žurbi. Mlad sam, tek sam otišao u penziju :)
Važno je svaki dan pomalo. A rad sa tekstovima me stvarno jako zanima, jer sam prevodilac i svaki dan radim sa njima. Pa da sebi malo olakšam.
Naravno, završivši studije jezika, nemam pojma o programiranju. Jedina olakšavajuća okolnost mi je što sam ceo vek bio znatiželjan i nije mi teško da učim nove stvari.
Tako da koliko god od pythona da naučim, čist dobitak. Programerima sigurno neću uzimati lebac.
I za kraj, ovo oko rečenice. U tekstovima sa kojima ja radim, rečenica se završava (uglavnom) tamo gde je tačka, znak pitanja ili uzvika i tu je sečem. Naravno, tačaka ima i unutar rečenice, ali to ćemo Panta i ja da rešimo u trećoj fazi ovog mega projekta. Sad smo još na početku druge :)
U svakom slučaju, hvala ti na komentaru i ako budeš imao ideja kako da rešimo ove naše petljavine, slobodno piši, pošto vidim da si upućen u NLTK. Unapred sam ti zavalan.
Citat:
peromalosutra:
@a1234567
Sto se tice greske sa poslednjeg screenshota, ne mozes da koristis backslash (\) karakter unutar stringa, jer on ima specijalno znacenje i sluzi za definisanje escape sequenci. Da bi ubacio taj karakter u string, moras i njega da "ekskejpujes" (jbg, ne znam nas termin), tako sto koristis dupli backslash "\\".
dakle, umjesto ovog:
stavi ovo:
@a1234567
Sto se tice greske sa poslednjeg screenshota, ne mozes da koristis backslash (\) karakter unutar stringa, jer on ima specijalno znacenje i sluzi za definisanje escape sequenci. Da bi ubacio taj karakter u string, moras i njega da "ekskejpujes" (jbg, ne znam nas termin), tako sto koristis dupli backslash "\\".
dakle, umjesto ovog:
Code:
a = 'c:\neka\putanja.txt'
stavi ovo:
Code:
a = 'c:\\neka\\putanja.txt'
Jao jeste, to sam pročitao u ovoj knjizi po kojoj idem, ali... zaboravio :(
Hvala ti na podsećanju.
Sad se sećam, kad je novi red onda ide \n ili enter \r
Interpreter mi javlja grešku, a ja ga ignorišem :)))
"eskejpuješ", pa to je naša stara reč, nema brige. Vuk Karadžić je još koristio kad je bežao iz Srbije :)))
Citat:
Panta_:
Umesto w (write) stavi a (append): with open('novi.txt', 'a') as nf
Citat:
E sad je problem što ovo upisivanje u fajl na kraju ne radi. Napravi fajl novi.txt, ali je prazan. Ne upiše to što izlistava na ekranu.
Gde gešim?
Gde gešim?
Umesto w (write) stavi a (append): with open('novi.txt', 'a') as nf
stavio a umesto w, ali opet samo napravi prazan novi.txt fajl, ne upisuje text u njega.
Citat:
stavio a umesto w, ali opet samo napravi prazan novi.txt fajl, ne upisuje text u njega.
Stavio si with blok izvan for petlje tako da nema sta da upiše, petlja ti se izvršila (vidi šta ti je l, print(l), nakon izvršenja for petlje, to će i da upiše. Stavi with ispod print(l), ili nešto ovako:
Code (python):
with open('original.txt', encoding='utf-8') as of:
for line in of:
with open('novi.txt', 'a') as novi:
# Podeli tekst kad naiđeš na '.' or ? or !.
for l in re.split(r"\.|\?|\!",line):
# Izlistaj na ekranu
print(l)
# Upiši rezultat u novi.txt
novi.write(l)
with open('original.txt', encoding='utf-8') as of:
for line in of:
with open('novi.txt', 'a') as novi:
# Podeli tekst kad naiđeš na '.' or ? or !.
for l in re.split(r"\.|\?|\!",line):
# Izlistaj na ekranu
print(l)
# Upiši rezultat u novi.txt
novi.write(l)
Citat:
Iseckaj prevod kao sto si i original i spoji po dve recenice u jedan list: ['Tekst jedan ...', 'Tekst dva ...'].
I ubaci u csv red: writer.writerow([line1, line2])
Najbolje je da napravis univerzalno resenje, pa samo da dodajes jezike:
Code:
writeList = []
languages = ['rs.txt', 'en.txt', 'de.txt'] # nevazno koliko fajlova, samo dodaj path
for langId, languageFile in enumerate(languages):
fh = open(languageFile)
lines = fh.read().replace('\n', '')
fh.close()
lines = nltk.sent_tokenize(lines)
for lineId, line in enumerate(lines):
if langId == 0:
writeList.insert(lineId, [])
writeList[lineId].insert(langId, line)
with open('moj_fajl.csv', 'w', newline='') as csv_file:
writer = csv.writer(csv_file)
writer.writerows(writeList)
Citat:
Panta_:
Stavio si with blok izvan for petlje tako da nema sta da upiše, petlja ti se izvršila (vidi šta ti je l, print(l), nakon izvršenja for petlje, to će i da upiše. Stavi with ispod print(l), ili nešto ovako:
Citat:
stavio a umesto w, ali opet samo napravi prazan novi.txt fajl, ne upisuje text u njega.
Stavio si with blok izvan for petlje tako da nema sta da upiše, petlja ti se izvršila (vidi šta ti je l, print(l), nakon izvršenja for petlje, to će i da upiše. Stavi with ispod print(l), ili nešto ovako:
Code (python):
with open('original.txt', encoding='utf-8') as of:
for line in of:
with open('novi.txt', 'a') as novi:
# Podeli tekst kad naiđeš na '.' or ? or !.
for l in re.split(r"\.|\?|\!",line):
# Izlistaj na ekranu
print(l)
# Upiši rezultat u novi.txt
novi.write(l)
with open('original.txt', encoding='utf-8') as of:
for line in of:
with open('novi.txt', 'a') as novi:
# Podeli tekst kad naiđeš na '.' or ? or !.
for l in re.split(r"\.|\?|\!",line):
# Izlistaj na ekranu
print(l)
# Upiši rezultat u novi.txt
novi.write(l)
Zanimljiv slučaj, popravio kod kao što si napisao
Code:
import re
with open('engleski.txt', encoding='utf-8') as eng:
for line in eng:
with open('engleski_redovi.txt', 'w+') as eng_red:
for l in re.split(r"\.|\?|\!",line):
print(l)
eng_red.write(l)
eng_red.close()
import re
with open('engleski.txt', encoding='utf-8') as eng:
for line in eng:
with open('engleski_redovi.txt', 'w+') as eng_red:
for l in re.split(r"\.|\?|\!",line):
print(l)
eng_red.write(l)
eng_red.close()
Na ekranu izlista tekst podeljen na rečenice, svaka u novom redu,
a u fajlu "engleski_redovi.txt" tekst nepromenjen, sav u jednom pasusu.
Druga stvar, ovaj regex kad ga secka na tački, on izbriše tačku. Kako da je ostavim na kraju rečenice?
Citat:
Deunan:
Iseckaj prevod kao sto si i original i spoji po dve recenice u jedan list: ['Tekst jedan ...', 'Tekst dva ...'].
I ubaci u csv red: writer.writerow([line1, line2])
Najbolje je da napravis univerzalno resenje, pa samo da dodajes jezike:
Iseckaj prevod kao sto si i original i spoji po dve recenice u jedan list: ['Tekst jedan ...', 'Tekst dva ...'].
I ubaci u csv red: writer.writerow([line1, line2])
Najbolje je da napravis univerzalno resenje, pa samo da dodajes jezike:
Code:
writeList = []
languages = ['rs.txt', 'en.txt', 'de.txt'] # nevazno koliko fajlova, samo dodaj path
for langId, languageFile in enumerate(languages):
fh = open(languageFile)
lines = fh.read().replace('\n', '')
fh.close()
lines = nltk.sent_tokenize(lines)
for lineId, line in enumerate(lines):
if langId == 0:
writeList.insert(lineId, [])
writeList[lineId].insert(langId, line)
with open('moj_fajl.csv', 'w', newline='') as csv_file:
writer = csv.writer(csv_file)
writer.writerows(writeList)
Nemam ja više jezika, samo engleski i srpski.
Spojena dva teksta bi trebalo ovako da izgledaju pre uvoza u Calc tabelu:
eng_rečenica1,srp_rečenica1
eng_rečenica2,srp_rečenica2
eng_rečenica3,srp_rečenica3
Probao sam ovaj kod, ali javlja grešku:
File "C:\Users\ja_sa\AppData\Local\Programs\Python\Python37-32\lib\encodings\cp1252.py", line 23, in decode
return codecs.charmap_decode(input,self.errors,decoding_table)[0]
UnicodeDecodeError: 'charmap' codec can't decode byte 0x8d in position 5: character maps to <undefined>
Treba mu negde ubaciti encoding='utf-8'
jer windows je cp-1250, a moji txt fajlovi su utf-8
Evo ti programce u Rust-u String je uvek utf-8.
Code:
use std::fs::File;
use std::io::Read;
use std::io::Write;
fn main()->Result<(),String> {
let args:Vec<_> = std::env::args().collect();
if args.len() < 4 {
return Err(format!("usage: {} infile1 infile2 outfile",args[0]));
} else {
let mut inf1 = File::open(&args[1]).unwrap();
let mut inf2 = File::open(&args[2]).unwrap();
let (text1,text2) = (format(&mut inf1),format(&mut inf2));
let mut ouf = File::create(&args[3]).unwrap();
for (line1,line2) in text1.lines().zip(text2.lines()) {
let _ = ouf.write(line1.as_bytes());
let _ = ouf.write(",".as_bytes());
let _ = ouf.write(line2.as_bytes());
let _ = ouf.write("\n".as_bytes());
}
Ok(())
}
}
fn format(inf:&mut File)->String {
let mut text = String::new();
let mut buf = String::new();
let _ = inf.read_to_string(&mut text);
for line in text.lines() {
buf.push_str(&line);
buf.push(' ');
}
text.clear();
let mut sent = String::new();
for c in buf.chars() {
if c != ' ' { sent.push(c); }
else { sent.push('_'); }
if c == '.' {
text.push_str(&sent);
text.push('\n');
sent.clear();
}
}
text.push_str(&sent);
sent.clear();
text
}
Hvala ti, Branimire, ali ne bih da menjam jezik.
Odlučio sam se da naučim koliko-toliko python, pa dokle stignem.
Sad samo čekam još da Panta i Deunan postignu da mi daju neki hint. :))
Odlučio sam se da naučim koliko-toliko python, pa dokle stignem.
Sad samo čekam još da Panta i Deunan postignu da mi daju neki hint. :))
Pa prevedi ovo u python onda :P
Ja sam mislio da tebi treba program za to...
Citat:
Na ekranu izlista tekst podeljen na rečenice, svaka u novom redu,
a u fajlu "engleski_redovi.txt" tekst nepromenjen, sav u jednom pasusu.
A gde ti je nov red u write? Dakle, stavi eng_red.write('{}\n'.format(l)) ili eng_red.write(f'{l}\n') u zavisnosti koju verziju Pythona koristis.
Citat:
Druga stvar, ovaj regex kad ga secka na tački, on izbriše tačku. Kako da je ostavim na kraju rečenice?
Na primer:
Code:
text = 'Prva recenica. Druga recenica! Treca recenica? Cetvrta, recenica.'
for l in re.split(r"(?<=\.|\?|\!)\s", text):
print(l)
Prva recenica.
Druga recenica!
Treca recenica?
Cetvrta, recenica.
text = 'Prva recenica. Druga recenica! Treca recenica? Cetvrta, recenica.'
for l in re.split(r"(?<=\.|\?|\!)\s", text):
print(l)
Prva recenica.
Druga recenica!
Treca recenica?
Cetvrta, recenica.
Pogledaj (?<=) (positive lookbehind assertion)
Citat:
Evo ti programce u Rust-u
Jos malo pa kao u Brainfucku.
Citat:
Branimir Maksimovic:
Pa prevedi ovo u python onda :P
Ja sam mislio da tebi treba program za to...
Pa prevedi ovo u python onda :P
Ja sam mislio da tebi treba program za to...
Treba mi program, ali bih umesto ribe, voleo da naučim da pecam :)
U svakom slučaju, hvala još jednom na trudu.
